A Google lançou hoje o Gemini 3.8 Flash, terceiro Flash em seis semanas, e o apresentou como seu melhor modelo de raciocínio e programação no preço e na velocidade da linha de trabalho. Essa frase cabe num comunicado. Não cabe, sozinha, num artigo.
O que mudou para mim não foi a versão. Foi o modelo atravessar um limiar que eu já tinha visto uma vez. Quando o Grok 4.5 começou a servir para programar, a diferença não estava numa linha de tabela. Estava no fato de eu conseguir deixá-lo fechar o ciclo: ler o estado real da máquina, executar, errar, corrigir e seguir. Documentei isso na migração para o Linux. O Gemini 3.8 Flash chegou, na minha experiência, a esse mesmo ponto.
Ele entrou no grupo pequeno de modelos que já executam o dia a dia.
O lançamento descreve um workhorse, não um modelo de fronteira
Segundo o anúncio da Google, o Gemini 3.8 Flash é o “workhorse” da casa: melhorias em engenharia de software, tarefas agênticas e raciocínio em vários passos, no mesmo preço introdutório do 3.7 Flash, US$ 0,75 por milhão de tokens de entrada e US$ 3,75 por milhão de tokens de saída até 31 de dezembro de 2026. A partir de 1º de janeiro de 2027, a tarifa prevista sobe para US$ 1,50 e US$ 7,50. O ID da API, já em GA, é gemini-3.8-flash. Não há, nesta data, um Gemini 3.8 Pro.
A Google afirma que o modelo “trabalha mais”: em tarefas complexas dá passos extras de raciocínio e chama ferramentas de forma iterativa. A tabela oficial de evals deixa o lugar do ganho visível. Terminal-bench 2.1 sobe de 81,6% no 3.7 Flash para 90,8% no 3.8. SWE-Bench Pro quase não se move: 60,4% para 61,6%. O salto está no loop longo, não no exame clássico de issue. No DeepSWE v1.1 da Datacurve, atualizado hoje, o gemini-3.8-flash em high marca 74% ±1% pass@1, contra 65% ±2% do 3.7 Flash, empatado com o Claude Opus 5 em max. A metodologia da DeepMind registra essa linha como self-computed, harness mini-swe-agent, thinking high. Custa em média US$ 2,36 por tarefa nessa board, contra US$ 11,84 do Opus 5, e gasta mais tokens que o 3.7: 143 mil contra 107 mil. Isso confirma o comunicado e, ao mesmo tempo, explica a conta: o workhorse ficou melhor porque trabalha mais tempo no harness, não porque o token ficou mais barato.
Há uma variante Cyber, restrita a defensores no programa Fairwind, treinada para descoberta de vulnerabilidades e correção. A Google diz que parte dos ganhos de programação do núcleo compartilhado veio desse treino. É uma hipótese da própria empresa, não um resultado que eu tenha reproduzido.
O ponto de distribuição importa mais do que o slogan. O 3.8 Flash entra na API Gemini, no Google AI Studio, no Android Studio, no Gemini Enterprise e, para quem programa, no Antigravity, a plataforma agêntica da Google. No meu caso, ele apareceu hoje no Antigravity CLI (agy), ao lado do 3.7, do 3.6, do 3.1 Pro, de dois Claude e de um GPT-OSS, com seletor de esforço em low, medium e high.
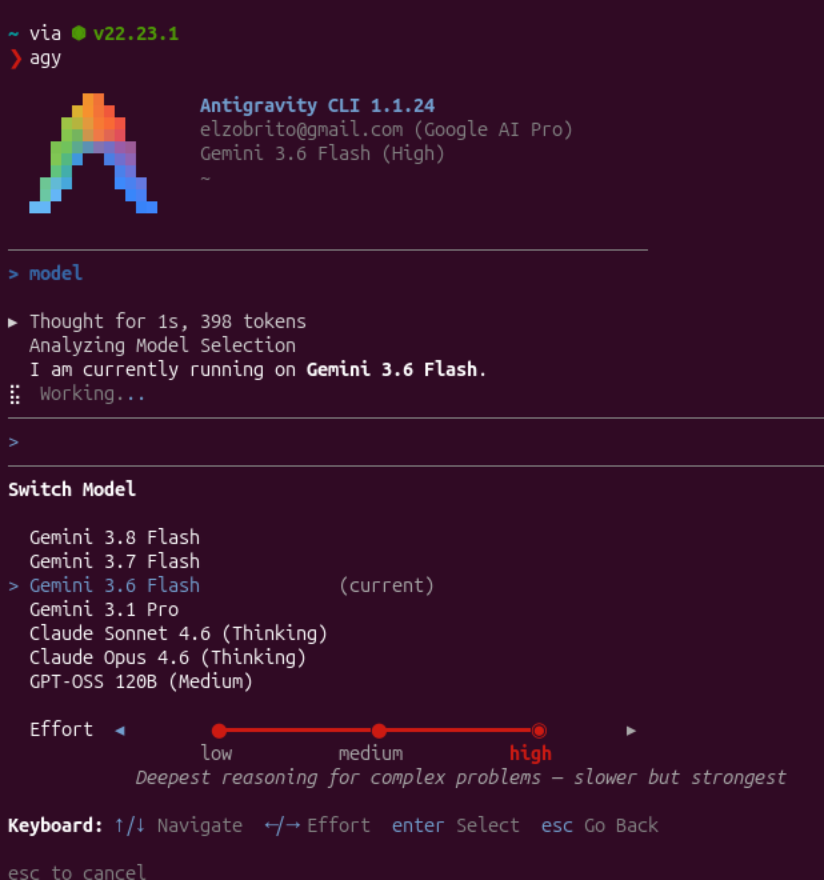
Isso já é um fato de produto: o modelo de trabalho da Google passou a ocupar o mesmo tipo de superfície em que um desenvolvedor troca de cérebro no meio do fluxo.
O Grok 4.5 foi o limiar, não o placar
O Grok 4.5 chegou ao Cursor em 8 de julho de 2026 e a xAI publicou o anúncio em 16 de julho, com a mesma tese de produto dita por outro laboratório: modelo treinado para código e tarefas agênticas, ao lado do Cursor, disponível no Grok Build e na API, a US$ 2 e US$ 6 por milhão de tokens. A xAI publicou DeepSWE, Terminal Bench e SWE-Bench Pro. Como sempre, o harness de cada medição não é o mesmo. O sucessor, Grok 4.6, saiu em 12 de agosto e é o Grok que a xAI recomenda hoje para código. O 4.5 continua disponível. Não existe, nesta data, um confronto oficial de coding entre Grok 4.5 e Gemini 3.8 Flash: o 3.8 ainda não tinha sido anunciado quando aqueles gráficos foram montados.
A Artificial Analysis mediu o Gemini 3.8 Flash (high) em 59 no Intelligence Index, três pontos acima do 3.7 Flash (high, 56). No mesmo índice, o Grok 4.5 (high) está em 56. O Grok 4.6 (high) já está em 61. O 3.8 Flash (high) empata com o Grok 4.6 em esforço medium, também 59. No Vals Index de 1º de setembro, um composto independente, o Gemini 3.8 Flash aparece com 62,25% e o Grok 4.6 com 59,17%. Continua sendo índice, não SWE, e não inclui o 4.5.
Esses números descrevem vizinhança, não identidade. Também escondem um detalhe que a própria Artificial Analysis deixa explícito: o custo por tarefa do 3.8 Flash (high) ficou em US$ 0,58, cerca de 40% acima do 3.7 Flash, apesar do preço por token inalterado. O modelo gasta mais tokens e faz mais turnos em avaliações agênticas. Barato por token não é barato por tarefa. Já tratei essa distinção quando a inteligência virou variável de orçamento.
Nenhuma dessas tabelas responde à pergunta que eu estava fazendo. A pergunta era: este modelo aguenta o meu fluxo?
O exame foi um harness complexo, não um prompt de código
Já escrevi que o modelo é um cérebro numa jarra. Dois produtos com o mesmo peso podem parecer sistemas diferentes porque o harness muda: ferramentas, memória e o loop que transforma raciocínio em ação. O ESAA é, para o meu trabalho, um harness complexo. Não é um chat com um arquivo aberto. É intenção, contrato, evidência, revisão e um rastro do que de fato aconteceu.
Foi isso que o Gemini 3.8 Flash passou a fazer de forma satisfatória.
O caso concreto: gerei a aula 09 de um curso, sobre Python e SQLite, no Antigravity. O contexto era grande. Havia aulas anteriores, uma skill minha de criação de aulas e a exigência de não tratar cada encontro como peça isolada. O modelo seguiu os passos, não se perdeu no meio do material e citou as aulas passadas. No fim da execução, devolveu informações do próprio run: o tipo de evidência que um harness decente precisa expor se quiser ser auditável.
Nem tudo saiu completo. Faltaram trechos na aula. A justificativa do modelo foi reutilizar arquivos já feitos. Isso não é erro de raciocínio. É uma decisão de reuso que um professor ainda precisa revisar. Qualidade editorial continua sendo mais importante que volume, na aula tanto quanto no blog.
A leitura que faço, e que é opinião, não benchmark: o Gemini 3.8 Flash chegou ao ponto em que o Grok 4.5 chegou quando deixou de ser um gerador de trechos e passou a executar trabalho. Não estou dizendo que os dois são o mesmo modelo, nem que o 3.8 Flash venceu o Grok 4.6, o Claude ou quem ocupe o topo da semana. Estou dizendo que ele entrou no grupo em que eu já confio para uma tarefa longa, com regras, memória de projeto e risco real de se perder.
Esse grupo ainda é pequeno.
O que isso muda, e o que ainda não muda
Para quem desenvolve, a consequência prática é de roteamento. O modelo de fronteira deixa de ser o único candidato a sentar no loop. O workhorse, barato o bastante para iterar e capaz o bastante para não abandonar um procedimento, vira opção default em muita tarefa do dia. O seletor de esforço do Antigravity, visível na mesma tela em que se troca o modelo, é o mecanismo: low, medium ou high não são um detalhe de interface. São orçamento cognitivo.
Para quem avalia modelos, a consequência é outra. DeepSWE, Terminal Bench e índices compostos continuam úteis para localizar a vizinhança. Não substituem o teste sujo: um harness com regras próprias, contexto que não cabe num exemplo, dependência de artefatos anteriores e um humano que sabe quando o resultado ficou incompleto. Uma pontuação sem a receita de montagem já era um número frágil. Uma pontuação sem o harness em que você realmente trabalha é um número de outra profissão.
O limite precisa ficar visível. Eu não reproduzi o DeepSWE da Google. Não tenho um head-to-head independente, no mesmo harness, entre Gemini 3.8 Flash e Grok 4.5. A evidência de que “entrou no grupo” é operacional: uma execução longa, no meu fluxo, com um harness que eu já usava para rejeitar modelos. Isso basta para decidir o que eu coloco no agy amanhã. Não basta para declarar uma ordem universal.
Há ainda o custo escondido no “trabalha mais”. Se o 3.8 Flash ganha capacidade gastando mais tokens por tarefa, o preço introdutório do Flash continua sendo um desconto sobre uma conta que cresce com o loop. Quem colocar o modelo no padrão high para tudo vai redescobrir, mais cedo, que inteligência é variável de orçamento.
O ranking vai continuar se movendo. O Grok 4.6 já está à frente do 4.5 no índice da Artificial Analysis; outros workhorses vão cruzar a mesma linha nas próximas semanas. O que não deve se mover é o critério. Um modelo serve para programar quando sobrevive ao harness em que o trabalho realmente acontece, devolve evidência do que fez e ainda deixa o humano ver o que faltou.
O Gemini 3.8 Flash, hoje, passou nesse exame.